Jak zablokować boty AI w WordPressie (GPTBot, ClaudeBot, robots.txt) i kiedy ma to sens
Boty AI blokuje się w WordPressie przez plik robots.txt, dodając regułę Disallow: / dla konkretnych user-agentów. Najważniejsza rzecz jest jednak inna: blokowanie bota od trenowania modelu, czyli GPTBot, to co innego niż blokowanie bota od wyszukiwania, czyli OAI-SearchBot. Jeśli zablokujesz ten drugi, znikasz z odpowiedzi ChatGPT, a razem z nimi z miejsca, w którym coraz częściej szukają Twoi klienci. Dlatego najpierw decyzja, potem edycja pliku.
Zanim przejdziesz do reguł, jedna obserwacja z praktyki. Przejrzałam dwadzieścia ostatnich rozmów z osobami, które zgłaszały się do mnie w sprawie stron. Ani razu nikt nie zapytał, jak zablokować boty AI. Temat pojawiał się kilkukrotnie, ale zawsze w drugą stronę: jak sprawić, żeby roboty weszły i żeby czaty cytowały firmę. To warto mieć z tyłu głowy przy czytaniu poradników o „ochronie treści przed AI”. Realne pytanie właścicieli firm brzmi dziś inaczej.
Ten tekst jest praktycznym uzupełnieniem artykułu o tym, jak marka pojawia się w odpowiedziach AI. Tam opisuję, jak być w odpowiedziach. Tutaj, jak się z nich świadomie wypisać i jak nie zrobić tego przez przypadek.
Dla większości firm i specjalistów raczej nie. Jeśli zależy Ci, żeby AI wymieniało Twoją markę i cytowało stronę, blokada działa przeciwko Tobie. To świadomy wybór, nie bezpieczne ustawienie domyślne.
Blokada ma sens, gdy
masz treści, których nie chcesz oddawać do trenowania modeli: autorskie materiały, płatne zasoby, bazy wiedzy
chronisz sekcje prywatne: panele, strefy klienta, treści za logowaniem
widzisz w logach serwera, że konkretny bot generuje ruch obciążający serwer
Blokada nie ma sensu, gdy
chcesz „chronić treści przed kopiowaniem”. Blokada w robots.txt nie chroni przed kopiowaniem przez ludzi ani przez narzędzia, które jej nie respektują
chcesz zniknąć z AI Overviews. To nie działa w ten sposób, wyjaśniam niżej
robisz to prewencyjnie, bo „lepiej dmuchać na zimne”. W praktyce to rezygnacja z widoczności bez żadnej korzyści w zamian
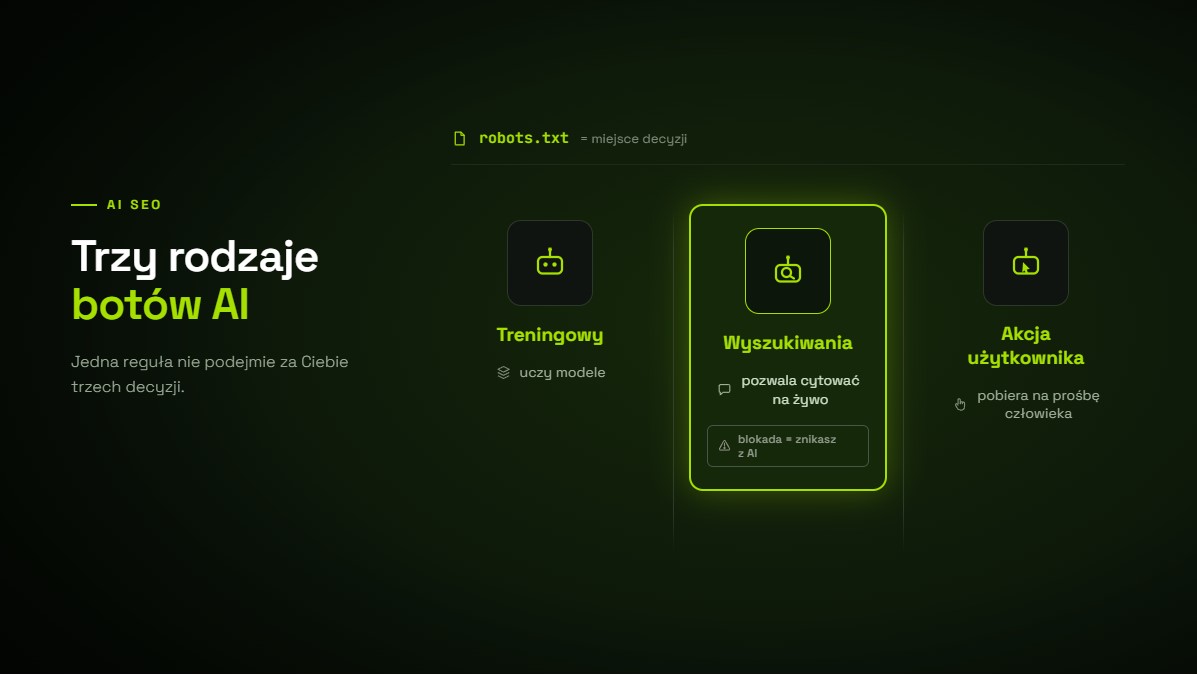
To jest sedno całego tematu. Jedna reguła w robots.txt nie podejmie za Ciebie trzech różnych decyzji.
Rodzaj bota
Co robi
Co oznacza blokada
Przykłady
Treningowy
pobiera treści do uczenia modeli
Twoje treści nie zasilą przyszłych wersji modeli
GPTBot, ClaudeBot, Google-Extended, CCBot
Wyszukiwania
indeksuje strony, żeby AI mogło je cytować na żywo
znikasz z odpowiedzi danego asystenta
OAI-SearchBot, Claude-SearchBot, PerplexityBot
Wywoływany przez użytkownika
pobiera konkretną stronę, gdy ktoś o to poprosi asystenta
blokujesz akcję, o którą poprosił żywy człowiek
ChatGPT-User, Perplexity-User, Claude-User
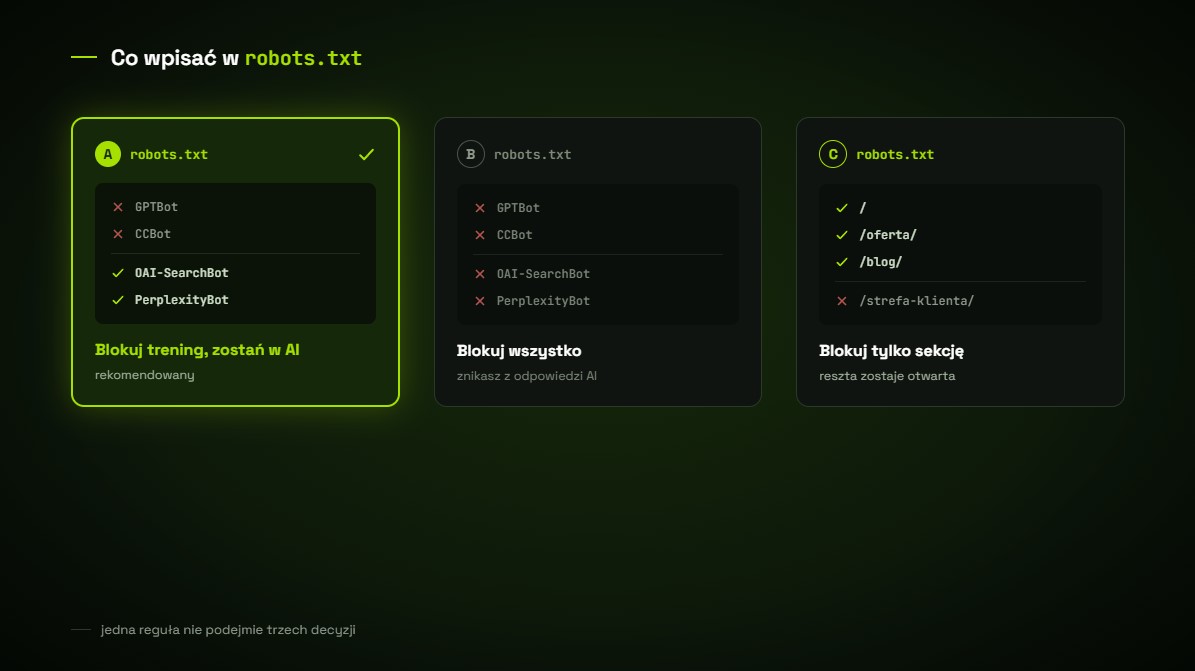
Najczęstszy błąd wygląda tak: ktoś chce chronić treści przed AI, blokuje wszystko jak leci i przy okazji wycina się z ChatGPT oraz Perplexity, czyli traci zapytania. Blokować trening i zostawić wyszukiwanie? Jak najbardziej. Odwrotnie też, choć rzadziej ma sens. Ważne, żeby to była decyzja, a nie efekt uboczny.
Trzeci wiersz tabeli zasługuje na osobne zdanie: blokowanie bota wywoływanego przez użytkownika oznacza, że gdy Twój potencjalny klient wkleja asystentowi adres Twojej strony i prosi o streszczenie oferty, dostaje komunikat o braku dostępu. Prawie nigdy nie jest to efekt, o który komuś chodziło.
Nazwy botów AI, które musisz znać
Reguła zadziała tylko wtedy, gdy nazwę user-agenta wpiszesz dokładnie tak, jak ogłasza się bot. Literówka, na przykład GPT-Bot zamiast GPTBot, cicho psuje całą regułę: plik wygląda poprawnie, a nie robi nic.
Yoast SEO: Yoast SEO, Narzędzia, Edytor plików. Zadziała, jeśli serwer pozwala na zapis
Fizyczny plik na serwerze: wgraj robots.txt do katalogu głównego strony przez menedżera plików hostingu albo FTP. Fizyczny plik ma pierwszeństwo przed wirtualnym
Plik zawsze jest pod adresem twojadomena.pl/robots.txt, a zmiany wchodzą w życie przy kolejnej wizycie bota. Przy okazji edycji sprawdź, czy masz w nim poprawnie wskazaną mapę witryny.
Co zrobić, jeśli nie masz dostępu do własnej strony. To brzmi jak sytuacja wyjątkowa, a nie jest. W moich dwudziestu ostatnich rozmowach czterokrotnie okazało się, że właściciel firmy nie może samodzielnie zmienić niczego na swojej stronie, bo dostęp trzyma poprzedni wykonawca. Bez dostępu do panelu albo serwera nie zmienisz robots.txt.
Krok 1: sprawdź, czy masz dostęp do panelu hostingu. To wystarczy, żeby wgrać fizyczny plik robots.txt, nawet bez logowania do WordPressa
Krok 2: jeśli nie, poproś wykonawcę o przekazanie danych. Dostęp należy się po zakończeniu prac i nie jest usługą dodatkową
Krok 3: jeśli nie ma kontaktu, przez panel hostingu da się odzyskać dostęp do strony w większości przypadków
Krok 4: przy okazji zapisz sobie te dane w jednym miejscu, razem z datą wygaśnięcia domeny
Każdy bot potrzebuje własnej reguły. Zezwolenie dla ClaudeBot nie zezwala automatycznie Claude-SearchBot, to trzeba wypisać osobno. Nie ma też czegoś takiego jak reguła zbiorcza „wszystkie boty AI”: User-agent: * obejmie także Googlebota, czyli zrobi coś zupełnie innego, niż zamierzasz.
Mit: blokada Google-Extended a pozycja w Google
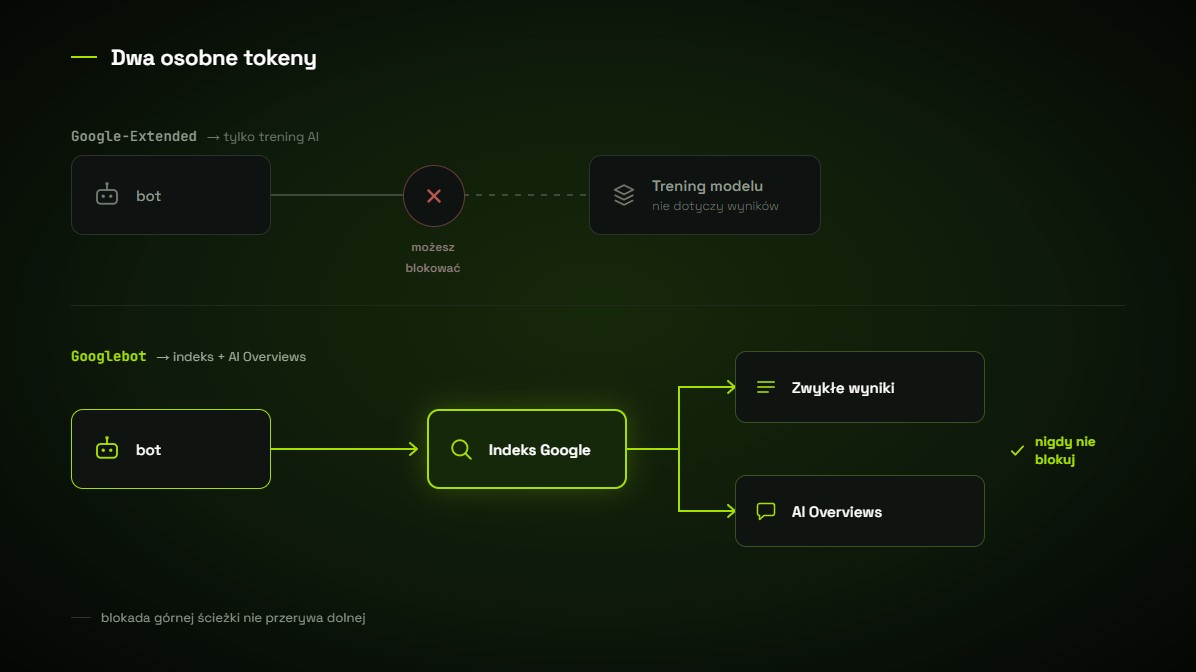
Tu mylą się nawet doświadczeni. Zablokowanie Google-Extended nie usuwa Cię z wyszukiwarki Google ani z AI Overviews. To osobny token dotyczący wyłącznie trenowania Gemini i Vertex AI. Indeksowanie robi Googlebot, którego nie blokujesz nigdy, bo to oznaczałoby zniknięcie z wyników.
Innymi słowy: nie istnieje osobny bot „od AI Overviews”. Podsumowania korzystają z normalnego indeksu Google. Jedyny sposób, żeby się z nich wypisać, to wypaść z Google w ogóle, czego raczej nie chcesz.
Jest jeden wyjątek warty wzmianki: znacznik nosnippet ogranicza wyświetlanie fragmentów Twojej treści w wynikach, a przy okazji w podsumowaniach. Cena jest jednak wysoka, bo tracisz też zwykły opis w wynikach wyszukiwania, więc w praktyce prawie nikt tego nie stosuje.
Jak sprawdzić, czy przypadkiem czegoś nie blokujesz
To jest sekcja, którą warto przejść nawet jeśli nigdy świadomie nic nie blokowałaś. Niektóre wtyczki i usługi mają przełącznik „Block AI Bots” włączony domyślnie albo włączający się po aktualizacji.
Cztery miejsca do sprawdzenia
Krok 1: otwórz twojadomena.pl/robots.txt w przeglądarce i przeczytaj, co tam faktycznie jest. To zajmuje trzydzieści sekund i wyłapuje większość przypadków
Krok 2: sprawdź ustawienia wtyczki SEO. W Rank Math i Yoast bywają opcje dotyczące botów AI
Krok 3: sprawdź wtyczki bezpieczeństwa i firewalle. To one najczęściej dokładają reguły bez pytania
Krok 4: jeśli korzystasz z Cloudflare, sprawdź ustawienia blokowania botów AI. Ta opcja bywa włączona przy podstawowej konfiguracji
Jeśli po tym przeglądzie okaże się, że coś jednak blokujesz, a nie chciałaś, usuń regułę i sprawdź w kolejnych tygodniach, czy marka wraca do odpowiedzi.
Nie zawsze. robots.txt to prośba, nie blokada techniczna. Grzeczne boty ją respektują, część crawlerów ignoruje.
Metoda
Skuteczność
Kiedy stosować
robots.txt
zależy od dobrej woli bota
domyślnie, przy większości zastosowań
reguła na poziomie serwera lub firewalla
wysoka
gdy naprawdę musisz coś odciąć
treść za logowaniem
pełna
materiały płatne i strefy klienta
znacznik noindex
dotyczy indeksowania, nie trenowania
inne zastosowanie, nie mylić z blokadą AI
Jeśli chodzi o materiały, na których naprawdę Ci zależy, jedyną pewną metodą jest umieszczenie ich za logowaniem. Wszystko inne opiera się na tym, że druga strona przestrzega zasad.
A co z plikiem llms.txt
llms.txt to osobny temat i nie służy do blokowania. To propozycja standardu, która wskazuje modelom najważniejsze treści, a nie ogranicza dostęp. Można powiedzieć, że robots.txt mówi „gdzie nie wchodź”, a llms.txt „zacznij stąd”.
Czy blokada GPTBot zaszkodzi mojej pozycji w Google?
Nie. GPTBot to crawler OpenAI i nie ma nic wspólnego z Googlebotem. Blokada Google-Extended też nie wpływa na wyniki Google, bo dotyczy wyłącznie trenowania Gemini.
Jak zablokować ClaudeBot w WordPressie?
Dodaj do robots.txt regułę User-agent: ClaudeBot i pod nią Disallow: /. Jeśli chcesz zostać w odpowiedziach Claude, nie blokuj przy okazji Claude-SearchBot, to osobny user-agent.
Zablokowałam wszystkie boty AI. Czy zniknę z ChatGPT?
Jeśli zablokowałaś OAI-SearchBot, to z wyszukiwania w ChatGPT tak. Żeby zostać w odpowiedziach, a wypisać się tylko z treningu, zostaw boty wyszukiwania i zablokuj wyłącznie treningowe.
Czy robots.txt na pewno zatrzyma każdego bota?
Nie. To prośba, którą grzeczne boty respektują, a część crawlerów ignoruje. Do twardego odcięcia potrzebna jest reguła na serwerze albo w firewallu.
Mam WordPress bez fizycznego pliku robots.txt. Jak go edytować?
Najprościej przez Rank Math albo Yoast SEO, albo wgrywając własny plik do katalogu głównego strony. Fizyczny plik ma pierwszeństwo przed wirtualnym.
Jak sprawdzić, czy reguły działają?
Otwórz twojadomena.pl/robots.txt i sprawdź, czy widzisz swoje reguły. Potem zajrzyj w logi serwera i poszukaj nazw botów, żeby zobaczyć, kto faktycznie wchodzi i czy respektuje zapisy.
Czy blokowanie botów AI chroni moje treści przed skopiowaniem?
Nie. Chroni przed wykorzystaniem ich przez boty, które reguł przestrzegają. Nie chroni przed kopiowaniem przez ludzi ani przez narzędzia, które robots.txt ignorują.
Czy warto blokować boty AI na blogu firmowym?
Zwykle nie. Blog jest najczęściej cytowaną częścią strony w odpowiedziach AI, więc blokada odcina Cię dokładnie tam, gdzie masz największą szansę na wzmiankę.
Jeszcze jedna rzecz z rozmów. Kiedy tłumaczę klientom, że do strony trzeba dodać pliki, które wpuszczają roboty i mówią im, co jest na stronie, nikt jeszcze nie zaprotestował. Reakcja jest zawsze ta sama: „dobra, róbmy”. Obawa przed AI podbierającym treści jest w mediach znacznie silniejsza niż w rozmowach z ludźmi, którzy prowadzą firmy i liczą zapytania.
Cała decyzja sprowadza się do jednego pytania: czy zależy Ci na tym, żeby AI mówiło o Twojej firmie, czy na tym, żeby Twoje treści nie zasilały modeli. To dwie różne rzeczy i można wybrać każdą z nich osobno. Jeśli chcesz sprawdzić, co Twoja strona dziś wpuszcza i czy nie blokujesz czegoś przez przypadek, napisz przez formularz.
Autor
Karolina Wcisło
Projektantka stron internetowych i materiałów graficznych. Od ponad 10 lat tworzę strony na WordPressie dla firm i specjalistów — zdalnie, dla klientów z całej Polski. Prowadzę jednoosobowe studio graficzno-webowe Click Made.
Boty AI blokuje się w WordPressie przez plik robots.txt, dodając regułę Disallow: / dla konkretnych user-agentów. Najważniejsza rzecz jest jednak inna: blokowanie bota od trenowania modelu, czyli GPTBot, to co…
Jak przygotować brief dla projektanta? Wystarczy jednostronicowy opis, który odpowiada na cztery pytania: co ma powstać, po co, dla kogo i gdzie będzie używane. Nie musi być długi ani ładny,…
GEO (Generative Engine Optimization) i AEO (Answer Engine Optimization) to optymalizacja strony pod systemy, które zamiast listy linków dają gotową odpowiedź: ChatGPT, AI Overviews w Google, Perplexity czy Copilot. W…
Teksty SEO najczęściej nie działają nie dlatego, że mają za mało słów kluczowych, tylko dlatego, że odpowiadają na inne pytanie niż to, które ktoś wpisał. Kolejne w kolejności są: wstęp…